Es war ein herrlicher Sommertag, als ich auf meinem Smartphone folgende Mail erhielt:
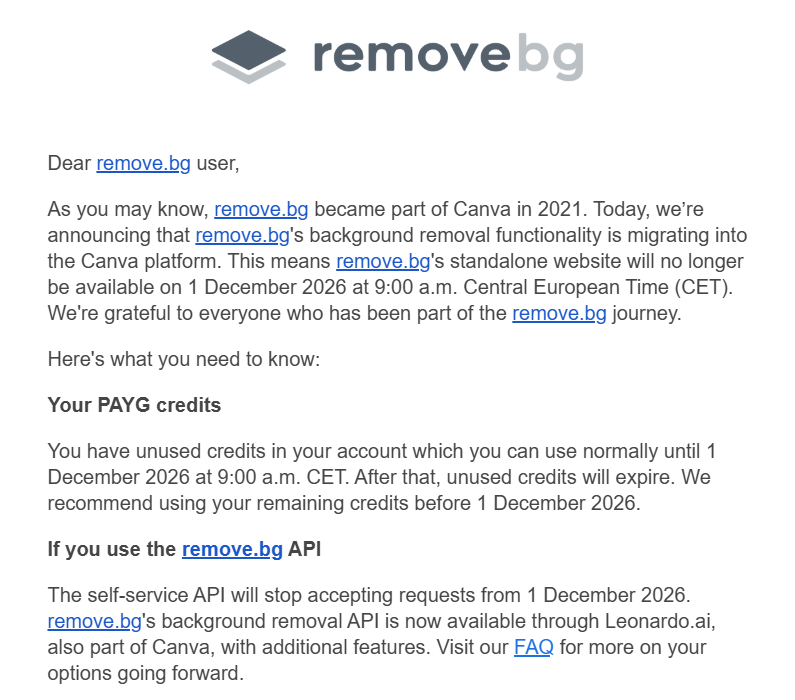
remove.bg - ein Vorreiter in Sachen "Hintergrund entfernen" und seit 2021 Teil von Canva - wird in die Canva-Plattform integriert. Die eigenständige Website verschwindet und die Self-Service API nimmt ab dem 1. Dezember 2026 keine Requests mehr an. Weiter geht es nur über Leonardo.ai, ebenfalls Teil von Canva.
Ob mich das damals schockiert hat? Nicht wirklich. Beeinträchtigt es unsere Anwendungen und Infrastruktur grundlegend? Auch nicht wirklich - denn in unseren Architekturen werden solche Änderungen bereits in der Planung berücksichtigt. Und genau darum geht es in diesem Blog-Eintrag!
Das Problem: Abhängigkeit von einem Drittanbieter
Stellt euch vor, ihr habt eine Anwendung, die freigestellte Bilder auf einer Website präsentiert. User laden Bilder hoch, eure Anwendung wendet etwas Intelligenz und IT-Magie an, und am Ende des Tages zeigt eure Website wunderschön freigestellte Bilder.
Die besagte IT-Magie kommt allerdings nicht aus eurer Anwendung, sondern von einem externen SaaS (Software as a Service). Bedeutet: Ihr verlasst euch für die Kernfunktionalität eurer Anwendung auf einen Drittanbieter.
Doch was passiert, wenn dieser Drittanbieter (in unserem Fall remove.bg) seine Tore schließt oder euch den Vertrag kündigt? Korrekt - eure Anwendung steht still.
In diesem Beitrag geht es aber nicht darum, wie man gefühlsmäßig mit so einer Änderung klarkommt, sondern wie man seine Anwendung so designt, dass Kernfunktionalitäten austauschbar und trotzdem einfach integrierbar sind.
Der Ansatz: Tightly Coupled vs. Loosely Coupled
Kleiner Disclaimer an dieser Stelle: Es gibt in der IT diverse Fachbegriffe, die in diesen Blog-Post passen würden - etwa Microservices, Service Oriented Architecture oder API-driven Architecture. Alle haben damit zu tun und wären auch gut fürs SEO. Ich werfe hier aber zwei Begriffe ein, die ursprünglich aus der Rechnerarchitektur kommen: Tightly Coupled Systems und Loosely Coupled Systems.
Tightly Coupled Systems
Bei einem tightly coupled System liegen die Funktionen einer Anwendung sehr "nah" beieinander - zum Beispiel direkt im selben Code. Das ist quasi das Standardverhalten, wenn ich eine Anwendung entwickle: Ich baue eine Funktion ein und eine zweite Funktion ruft die erste auf, und zwar innerhalb derselben Anwendung. Diese Funktionen kennen und sehen sich.
Das Problem dabei? Die Funktionen sind voneinander abhängig. Existiert Funktion 1 nicht mehr oder wirft permanent Fehler, ist Funktion 2 ebenfalls betroffen.
Ein weiteres Problem: Tightly coupled Systeme folgen meist dem Motto "Alles oder nichts". Muss eine Funktion geändert werden, muss die gesamte Anwendung neu kompiliert und ausgerollt werden. Bei Legacy-Anwendungen bzw. größeren Monolithen ist das immer aufwändig.
Weiterer Disclaimer: Natürlich kann man auch innerhalb derselben Anwendung mit Interfaces und Abstraktions-Patterns arbeiten, um Implementierungen voneinander zu isolieren. Um das Neukompilieren und Ausrollen kommt man trotzdem nicht herum.
Loosely Coupled Systems
Kleiner Spoiler: Das ist die Architekturentscheidung, die uns beim Austausch von remove.bg viele Nerven erspart.
Wie der Name sagt, sind loosely coupled Systeme nicht "eng" miteinander verbunden. Die Funktionen liegen in getrennten, isolierten Anwendungen und kommunizieren über ein gängiges Protokoll wie HTTP miteinander.
Unser Leitsatz: Was extern ist, sollte auch extern bleiben
Warum entscheiden wir uns meistens für loosely coupled Systeme? Ganz einfach: Die Welt wird immer komplexer und unsere Anwendungen müssen damit Schritt halten. Bei unseren Architekturentscheidungen halten wir uns an den Leitsatz "Was extern ist, sollte auch extern bleiben".
Zurück zu unserem Beispiel: Wir haben eine Anwendung, in der tief drinnen der Aufruf von remove.bg steckt. remove.bg wird abgedreht - die Anwendung verliert einen Teil ihrer Kernfunktionalität und muss umgebaut und neu kompiliert werden.
Was hätte man besser machen können? Den Aufruf des externen Systems nochmals in ein kleines eigenes System verpacken:
- Anwendung A (eure große Anwendung) ruft Minianwendung B auf.
- Minianwendung B hat nur eine Aufgabe: den Request an remove.bg weiterzuleiten und die Antwort an Anwendung A zurückzugeben.
Warum tue ich mir das an? Wird remove.bg abgedreht, muss ich nicht meine riesige, komplexe Anwendung A umschreiben - was immer mit potenziellen Downtimes oder Bugs verbunden ist. Stattdessen mache ich die Änderung gezielt in Minianwendung B und habe wieder ein funktionierendes Konstrukt. In der Fachliteratur findet ihr dieses Muster übrigens auch unter den Begriffen Adapter, Gateway oder Anti-Corruption Layer.
"Ok, schön und gut - aber ich kann die remove.bg-Parameter ja auch über Umgebungsvariablen bereitstellen und einfach austauschen, right?" Naja: Wie hoch ist die Wahrscheinlichkeit, dass zwei unabhängige Anbieter genau dieselbe Schnittstelle 1:1 anbieten (sofern es keine standardisierte Schnittstelle ist)? Genau, eher gering. Selbst der offizielle Nachfolger über Leonardo.ai ist eine eigene API. Ihr braucht also die Flexibilität, beim Wechsel des Anbieters auch den Aufruf anzupassen - ohne euer großes, monolithisches System anzufassen.
Ein weiterer Vorteil von loosely coupled Systemen: Das DRY-Prinzip (Don't Repeat Yourself) lässt sich deutlich besser umsetzen. Im Grunde bedeutet das, dass wir solche kleinen Komponenten in mehreren Anwendungen wiederverwenden können - dazu gibt es bald einen eigenen Beitrag.
Wie schaut das in der Praxis mit Azure aus?
TBH - es kommt auf euren Use Case, eure Unternehmensgröße und eure Capabilities an.
Variante 1: Azure API Management
Am elegantesten lässt sich das mit Azure API Management lösen. Dort hinterlegt ihr eure Drittanbieter-API direkt über die Azure-Oberfläche und bekommt eine eigene URL, die die API des Drittanbieters kapselt. Das API Management wäre in unserem Beispiel Minianwendung B - auch wenn diese Ressource noch sehr viel mehr kann. Für kleine Szenarien gibt es übrigens einen nutzungsbasierten Verbrauchstarif (Consumption), damit sich die Kosten in Grenzen halten.
Variante 2: Azure Functions
Wer den Overhead des API Managements nicht stemmen möchte, für den ist eine Azure Function interessant. Ihr schreibt eine kleine Funktion in .NET, Python oder Node.js, die den Aufruf der Hersteller-API übernimmt, und deployt sie als Function App - hoffentlich mit Pipelines (siehe weiteren Artikel).
Fazit
Ihr seht: Architekturentscheidungen, die früh getroffen und als Guideline im Unternehmen zur Verfügung gestellt werden, ersparen auf lange Sicht viel Kopfschmerzen. Auch wir kommen nicht drumherum, einen Ersatz für die remove.bg API zu finden. Aber die Umsetzung passiert gezielt an einer einzigen Stelle - ohne die großen, monolithischen Anwendungen umzubauen!
Kommentare
Kommentar hinterlassen
Kommentare werden moderiert und bei Regelverstößen oder Missbrauch ausnahmslos entfernt.